Volver a publicaciones

Homelab

Observabilidad en casa: Grafana, Prometheus y Loki sin ahogar el NAS

11 min de lectura
#grafana#prometheus#loki#observabilidad#docker#kubernetes

Portada: gráfica de líneas y barras de un panel de métricas sobre fondo oscuro con el título Observabilidad en casa

Puntos clave

  • Observabilidad es poder responder qué pasa y por qué: métricas, logs y alertas.
  • Prometheus guarda métricas, Loki guarda logs y Grafana los enseña; los recolectores alimentan a ambos.
  • En un NAS modesto el stack completo compite por la RAM con el resto de servicios.
  • Solución: el plano de control en un portátil con k3s y solo los recolectores en el NAS.
  • Retención y límites de memoria desde el primer día, y una alerta que llegue a alguien.

Durante meses mi forma de saber si algo iba mal en el NAS era esperar a que dejara de funcionar. Luego entraba por SSH, miraba docker ps y leía logs a mano. Funciona, pero siempre llegas tarde.

La observabilidad cambia eso: el sistema te cuenta cómo está, te enseña la historia y te avisa antes de que te enteres por las malas. En este capítulo explico el stack que uso, cómo lo tuve en el NAS, por qué tuve que sacarlo de ahí y cómo montarlo desde cero.

Qué es observabilidad (en corto)

Son tres fuentes de información que responden a tres preguntas:

  • Métricas: números en el tiempo. ¿Cuánta CPU, RAM y disco usa cada cosa? ¿Desde cuándo?
  • Logs: lo que escriben los servicios. ¿Qué pasó exactamente a las 03:12?
  • Alertas: reglas sobre las métricas. ¿Hay algo que deba saber ahora?

Qué vas a montar

Pieza Qué hace
Prometheus Pregunta a los exportadores cada pocos segundos y guarda las métricas
node-exporter Publica las métricas del host: CPU, memoria, disco, red
cAdvisor Publica las métricas de cada contenedor
Loki Guarda los logs, indexados por etiquetas
Promtail Lee los logs de los contenedores y los envía a Loki
Grafana Dashboards y exploración de métricas y logs

En mi stack original también estaba Tempo, para trazas distribuidas de mis aplicaciones. Para empezar no hace falta.

Requisitos

  • Docker y Docker Compose.
  • Unos 1,5 GB de RAM libres si lo montas todo en la misma máquina.
  • Caddy delante para Grafana, con el panel solo en LAN/VPN (ver la serie “Mi NAS paso a paso”).

La historia real: del NAS al portátil

Empezó en el NAS

Monté el stack completo en el NAS con Docker Compose, con límites de memoria para cada servicio y retención de 15 días o 2 GB en Prometheus. Como el NAS es modesto (un Celeron de cuatro núcleos), lo encendía bajo demanda: lo levantaba para enseñarlo y lo paraba para liberar RAM.

Cuando lo medí con todo levantado, el stack no era pesado: unos 670 MB de RAM real. El problema era el margen del NAS: con el resto de servicios le quedaban unos 2 GB libres y ya estaba usando 2 GB de swap. Cualquier pico empujaba a todo el sistema hacia el disco.

Por qué no k3s en el NAS

Quería aprender Kubernetes con un caso propio, así que lo primero fue intentar k3s en el NAS. Lo descarté tras revisar tres cosas del sistema del NAS:

  • Un kernel antiguo (4.4).
  • Un esquema de cgroups no estándar.
  • El módulo overlayfs no disponible, que containerd necesita.

Y aunque hubiera arrancado, el plano de control de k3s habría dejado al NAS en swap permanente.

La arquitectura resultante

La solución fue dividir. Hay piezas que tienen que estar en el NAS porque leen el propio NAS (/proc, /sys, los logs de los contenedores). El resto no depende del host y se puede ir a otra máquina.

Pieza Dónde vive Por qué
node-exporter NAS (Docker) Lee el hardware y el sistema del NAS
cAdvisor NAS (Docker) Lee los contenedores del NAS
Promtail NAS (Docker) Lee los logs del NAS y los empuja a Loki
Prometheus Portátil (k3s) Va a buscar las métricas al NAS por la red
Loki Portátil (k3s) Recibe los logs
Grafana Portátil (k3s) Se publica a través del Caddy del NAS
      NAS (Docker)                          Portátil (k3s)
  ┌──────────────────┐                  ┌──────────────────────┐
  │ node-exporter    │ ◄── scrape ───── │ Prometheus           │
  │ cAdvisor         │ ◄── scrape ───── │                      │
  │ Promtail ────────┼───── push ─────► │ Loki                 │
  │ Caddy ───────────┼──── proxy ─────► │ Grafana              │
  └──────────────────┘                  └──────────────────────┘

En k3s usé el chart de Helm kube-prometheus-stack (Prometheus, Grafana y Alertmanager en un paquete) y el chart de Loki en modo de un solo binario. El resultado: el NAS dejó de reservar ~1,5 GB de límites de memoria del plano de control a cambio de ~250 MB de los recolectores.

# En el portátil: instala k3s (trae Traefik y almacenamiento local)
curl -sfL https://get.k3s.io | sh -
sudo kubectl get nodes

# Repos de Helm y el stack de métricas en su propio namespace
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo add grafana https://grafana.github.io/helm-charts
helm repo update
helm install monitoring prometheus-community/kube-prometheus-stack \
  --namespace observability --create-namespace

Si empiezas, no hace falta todo esto. Monta primero el stack con Compose en una máquina con RAM de sobra; la división puede esperar.

Paso 1: el stack con Docker Compose

Estructura de carpetas:

observability/
├── docker-compose.yml
├── .env
├── prometheus/
│   ├── prometheus.yml
│   └── alerts.yml
├── loki/
│   └── loki.yml
├── promtail/
│   └── promtail.yml
└── grafana/
    └── provisioning/
        └── datasources/
            └── datasources.yml

El docker-compose.yml:

services:
  prometheus:
    image: prom/prometheus:v3.10.0
    container_name: prometheus
    restart: unless-stopped
    command:
      - --config.file=/etc/prometheus/prometheus.yml
      - --storage.tsdb.path=/prometheus
      - --storage.tsdb.retention.time=15d    # borra datos de más de 15 días
      - --storage.tsdb.retention.size=2GB    # o cuando ocupen más de 2 GB
    volumes:
      - ./prometheus:/etc/prometheus:ro
      - prometheus-data:/prometheus
    extra_hosts:
      - "host.docker.internal:host-gateway"  # para llegar a node-exporter en el host
    mem_limit: 512m

  node-exporter:
    image: prom/node-exporter:v1.9.1
    container_name: node-exporter
    restart: unless-stopped
    command:
      - --path.rootfs=/host
    volumes:
      - /:/host:ro
    network_mode: host                       # ve la red real del host; escucha en :9100
    pid: host
    mem_limit: 64m

  cadvisor:
    image: gcr.io/cadvisor/cadvisor:v0.52.1
    container_name: cadvisor
    restart: unless-stopped
    privileged: true
    command:
      - --docker_only=true
      - --housekeeping_interval=30s          # menos CPU que el valor por defecto
    volumes:
      - /:/rootfs:ro
      - /var/run:/var/run:ro
      - /sys:/sys:ro
      - /var/lib/docker:/var/lib/docker:ro
    mem_limit: 256m

  loki:
    image: grafana/loki:3.4.2
    container_name: loki
    restart: unless-stopped
    command: -config.file=/etc/loki/loki.yml
    volumes:
      - ./loki/loki.yml:/etc/loki/loki.yml:ro
      - loki-data:/loki
    mem_limit: 256m

  promtail:
    image: grafana/promtail:3.4.2
    container_name: promtail
    restart: unless-stopped
    command: -config.file=/etc/promtail/promtail.yml
    volumes:
      - ./promtail/promtail.yml:/etc/promtail/promtail.yml:ro
      - /var/lib/docker/containers:/var/lib/docker/containers:ro
      - promtail-data:/data
    depends_on:
      - loki
    mem_limit: 128m

  grafana:
    image: grafana/grafana:12.3.0
    container_name: grafana
    restart: unless-stopped
    env_file: .env                           # usuario y contraseña de administrador
    environment:
      GF_USERS_ALLOW_SIGN_UP: "false"
      GF_ANALYTICS_REPORTING_ENABLED: "false"
    volumes:
      - ./grafana/provisioning:/etc/grafana/provisioning:ro
      - grafana-data:/var/lib/grafana
    ports:
      - "127.0.0.1:3500:3000"                # solo el proxy llega a Grafana
    mem_limit: 256m

volumes:
  prometheus-data:
  loki-data:
  promtail-data:
  grafana-data:

Uso volúmenes con nombre para los datos: Prometheus, Loki y Grafana no se ejecutan como root dentro del contenedor, y con carpetas del host es fácil acabar con errores de permisos.

En un NAS Synology, los contenedores no están en /var/lib/docker. En el mío, cAdvisor y Promtail tuvieron que leer de /volume1/@docker y /volume1/@docker/containers. Comprueba la ruta de tu sistema.

El .env (sin valores en el ejemplo; ponlos tú y haz chmod 600 .env):

GF_SECURITY_ADMIN_USER=
GF_SECURITY_ADMIN_PASSWORD=

Paso 2: la configuración

prometheus/prometheus.yml, qué medir y cada cuánto:

global:
  scrape_interval: 30s        # cada cuánto pregunta a los exportadores
  evaluation_interval: 30s    # cada cuánto evalúa las alertas

rule_files:
  - /etc/prometheus/alerts.yml

scrape_configs:
  - job_name: prometheus
    static_configs:
      - targets: ["localhost:9090"]

  - job_name: node
    static_configs:
      - targets: ["host.docker.internal:9100"]

  - job_name: cadvisor
    static_configs:
      - targets: ["cadvisor:8080"]

loki/loki.yml, un Loki de un solo nodo con retención de 7 días:

auth_enabled: false

server:
  http_listen_port: 3100

common:
  path_prefix: /loki
  storage:
    filesystem:
      chunks_directory: /loki/chunks
      rules_directory: /loki/rules
  replication_factor: 1
  ring:
    kvstore:
      store: inmemory

schema_config:
  configs:
    - from: 2024-01-01
      store: tsdb
      object_store: filesystem
      schema: v13
      index:
        prefix: index_
        period: 24h

compactor:
  working_directory: /loki/compactor
  retention_enabled: true          # sin esto, los logs no se borran nunca
  delete_request_store: filesystem

limits_config:
  retention_period: 168h           # 7 días

promtail/promtail.yml, que lee los logs de todos los contenedores:

server:
  http_listen_port: 9080
  grpc_listen_port: 0

positions:
  filename: /data/positions.yaml   # recuerda por dónde iba tras un reinicio

clients:
  - url: http://loki:3100/loki/api/v1/push

scrape_configs:
  - job_name: docker
    static_configs:
      - targets: [localhost]
        labels:
          job: docker
          __path__: /var/lib/docker/containers/*/*-json.log
    pipeline_stages:
      - docker: {}                 # extrae el mensaje y la hora del formato JSON de Docker

Grafana aprovisiona sus fuentes de datos desde un fichero, así no hay que configurarlas a mano. grafana/provisioning/datasources/datasources.yml:

apiVersion: 1

datasources:
  - name: Prometheus
    type: prometheus
    access: proxy
    url: http://prometheus:9090
    isDefault: true

  - name: Loki
    type: loki
    access: proxy
    url: http://loki:3100

Un aviso sobre Promtail: es lo que yo uso, pero Grafana lo ha dado por obsoleto en favor de Grafana Alloy. Para un montaje nuevo a largo plazo, valora Alloy como agente de logs.

Paso 3: tu primer dashboard

docker compose up -d
docker compose ps

Entra en Grafana a través del proxy con el usuario del .env. Después:

  1. En Dashboards, elige importar un dashboard.
  2. Escribe el ID 1860 (“Node Exporter Full”, publicado en grafana.com) y selecciona la fuente Prometheus.
  3. Ya tienes CPU, memoria, disco y red del host.

Para los logs, abre Explore, elige Loki y prueba una consulta como {job="docker"} |= "error".

Paso 4: tu primera alerta

prometheus/alerts.yml, dos reglas que valen para cualquier servidor:

groups:
  - name: homelab
    rules:
      - alert: HostCaido
        expr: up{job="node"} == 0
        for: 2m                              # evita avisos por un fallo puntual
        labels:
          severity: critical
        annotations:
          summary: "node-exporter no responde desde hace 2 minutos"

      - alert: DiscoCasiLleno
        expr: |
          node_filesystem_avail_bytes{fstype!~"tmpfs|overlay"}
            / node_filesystem_size_bytes{fstype!~"tmpfs|overlay"} < 0.10
        for: 15m
        labels:
          severity: warning
        annotations:
          summary: "Queda menos de un 10 % de disco en {{ $labels.mountpoint }}"

Recarga Prometheus con docker compose restart prometheus y abre su página de alertas: verás las reglas en estado inactivo.

Una alerta que solo se ve en una página no avisa a nadie. Me pasó: en el NAS, el receptor de alertas estaba vacío y todas se descartaban en silencio. Desde que el stack vive en el portátil, las alertas se envían por ntfy y tengo reglas propias para el NAS caído, el disco o las copias de seguridad. Para enviarlas necesitas Alertmanager (viene en kube-prometheus-stack) o los puntos de contacto de Grafana. En el próximo capítulo monto un canal de avisos por Telegram.

El caso real: tres días sin observabilidad

La migración tuvo un tropiezo que enseña más que la parte técnica. Cuando moví el plano de control, paré el stack del NAS pensando en arrancar solo los recolectores. No lo hice. Durante tres días no hubo métricas ni logs, y mi documentación seguía diciendo que el stack del NAS “seguía funcionando” como respaldo.

Dos errores más aparecieron al arrancar los recolectores:

  • Conflicto de puerto. Para que el Prometheus del portátil llegara a cAdvisor, había que publicar su puerto. El 8080 ya lo usaba Caddy en el NAS. Publicarlo ahí habría roto el acceso web. Lo publiqué en otro puerto (8085:8080).
  • depends_on resucitando lo migrado. Promtail depende de Loki en el compose. Un docker compose up -d promtail levantaba también el Loki local, que era justo el que había migrado. La solución es --no-deps:
docker compose up -d --no-deps node-exporter cadvisor promtail

La lección: una documentación que no se comprueba contra la realidad es peor que no tener documentación, porque te da una falsa sensación de seguridad.

Problemas frecuentes

Síntoma Causa probable Solución
El target node aparece DOWN Prometheus no llega al host Revisa extra_hosts y el cortafuegos del puerto 9100
permission denied en /prometheus o /loki Carpeta del host con otro dueño Usa volúmenes con nombre
Promtail no envía nada Ruta de logs distinta (p. ej. en Synology) Monta la ruta real de los contenedores
Loki ocupa cada vez más Retención no activada retention_enabled y retention_period
El NAS va lento con el stack arriba Falta de RAM, uso de swap Límites de memoria o mueve el plano de control
Arranca un Loki que no querías depends_on en Promtail docker compose up -d --no-deps ...

Conclusión

Tener métricas y logs en un solo sitio me cambió la forma de diagnosticar: ya no adivino, miro. Las lecciones que me llevo: limita la memoria y la retención desde el principio, separa lo que tiene que vivir en el host de lo que puede irse a otra máquina y verifica que lo que dice tu documentación es cierto.

En el próximo capítulo monto Diun para saber cuándo hay imágenes nuevas y un bot de Telegram para que los avisos lleguen al móvil.

For months, the way I found out something was wrong on the NAS was waiting for it to stop working. Then I would log in over SSH, look at docker ps and read logs by hand. It works, but you are always late.

Observability changes that: the system tells you how it is doing, shows you its history and warns you before you find out the hard way. In this chapter I explain the stack I use, how I ran it on the NAS, why I had to move it off there and how to set it up from scratch.

What observability is (in short)

It is three sources of information that answer three questions:

  • Metrics: numbers over time. How much CPU, RAM and disk does each thing use? Since when?
  • Logs: what services write. What exactly happened at 03:12?
  • Alerts: rules on top of metrics. Is there something I need to know now?

What you will build

Piece What it does
Prometheus Asks the exporters every few seconds and stores the metrics
node-exporter Publishes host metrics: CPU, memory, disk, network
cAdvisor Publishes metrics for each container
Loki Stores logs, indexed by labels
Promtail Reads container logs and ships them to Loki
Grafana Dashboards and exploration of metrics and logs

My original stack also had Tempo, for distributed traces from my applications. You do not need it to get started.

Requirements

  • Docker and Docker Compose.
  • About 1.5 GB of free RAM if you run everything on the same machine.
  • Caddy in front of Grafana, with the panel on LAN/VPN only (see the “Mi NAS paso a paso” series).

The real story: from the NAS to the laptop

It started on the NAS

I set up the full stack on the NAS with Docker Compose, with memory limits for each service and 15 days or 2 GB of retention in Prometheus. Since the NAS is modest (a four-core Celeron), I ran it on demand: I started it to show it and stopped it to free RAM.

When I measured it with everything running, the stack was not heavy: about 670 MB of real RAM. The problem was the NAS’s headroom: with the other services it had about 2 GB free and was already using 2 GB of swap. Any spike pushed the whole system onto the disk.

Why not k3s on the NAS

I wanted to learn Kubernetes with a case of my own, so the first thing I tried was k3s on the NAS. I ruled it out after checking three things about the NAS’s system:

  • An old kernel (4.4).
  • A non-standard cgroups setup.
  • The overlayfs module not available, which containerd needs.

And even if it had started, the k3s control plane would have left the NAS in permanent swap.

The resulting architecture

The solution was to split it. Some pieces must live on the NAS because they read the NAS itself (/proc, /sys, container logs). The rest does not depend on the host and can move to another machine.

Piece Where it lives Why
node-exporter NAS (Docker) Reads the NAS’s hardware and system
cAdvisor NAS (Docker) Reads the NAS’s containers
Promtail NAS (Docker) Reads the NAS’s logs and pushes them to Loki
Prometheus Laptop (k3s) Pulls metrics from the NAS over the network
Loki Laptop (k3s) Receives the logs
Grafana Laptop (k3s) Published through the NAS’s Caddy
      NAS (Docker)                          Laptop (k3s)
  ┌──────────────────┐                  ┌──────────────────────┐
  │ node-exporter    │ ◄── scrape ───── │ Prometheus           │
  │ cAdvisor         │ ◄── scrape ───── │                      │
  │ Promtail ────────┼───── push ─────► │ Loki                 │
  │ Caddy ───────────┼──── proxy ─────► │ Grafana              │
  └──────────────────┘                  └──────────────────────┘

On k3s I used the kube-prometheus-stack Helm chart (Prometheus, Grafana and Alertmanager in one package) and the Loki chart in single-binary mode. The result: the NAS stopped reserving ~1.5 GB of control-plane memory limits in exchange for ~250 MB for the collectors.

# On the laptop: install k3s (it ships Traefik and local storage)
curl -sfL https://get.k3s.io | sh -
sudo kubectl get nodes

# Helm repos and the metrics stack in its own namespace
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo add grafana https://grafana.github.io/helm-charts
helm repo update
helm install monitoring prometheus-community/kube-prometheus-stack \
  --namespace observability --create-namespace

If you are just starting, you do not need any of this. First run the stack with Compose on a machine with plenty of RAM; the split can wait.

Step 1: the stack with Docker Compose

Folder layout:

observability/
├── docker-compose.yml
├── .env
├── prometheus/
│   ├── prometheus.yml
│   └── alerts.yml
├── loki/
│   └── loki.yml
├── promtail/
│   └── promtail.yml
└── grafana/
    └── provisioning/
        └── datasources/
            └── datasources.yml

The docker-compose.yml:

services:
  prometheus:
    image: prom/prometheus:v3.10.0
    container_name: prometheus
    restart: unless-stopped
    command:
      - --config.file=/etc/prometheus/prometheus.yml
      - --storage.tsdb.path=/prometheus
      - --storage.tsdb.retention.time=15d    # delete data older than 15 days
      - --storage.tsdb.retention.size=2GB    # or once it takes more than 2 GB
    volumes:
      - ./prometheus:/etc/prometheus:ro
      - prometheus-data:/prometheus
    extra_hosts:
      - "host.docker.internal:host-gateway"  # to reach node-exporter on the host
    mem_limit: 512m

  node-exporter:
    image: prom/node-exporter:v1.9.1
    container_name: node-exporter
    restart: unless-stopped
    command:
      - --path.rootfs=/host
    volumes:
      - /:/host:ro
    network_mode: host                       # sees the host's real network; listens on :9100
    pid: host
    mem_limit: 64m

  cadvisor:
    image: gcr.io/cadvisor/cadvisor:v0.52.1
    container_name: cadvisor
    restart: unless-stopped
    privileged: true
    command:
      - --docker_only=true
      - --housekeeping_interval=30s          # less CPU than the default
    volumes:
      - /:/rootfs:ro
      - /var/run:/var/run:ro
      - /sys:/sys:ro
      - /var/lib/docker:/var/lib/docker:ro
    mem_limit: 256m

  loki:
    image: grafana/loki:3.4.2
    container_name: loki
    restart: unless-stopped
    command: -config.file=/etc/loki/loki.yml
    volumes:
      - ./loki/loki.yml:/etc/loki/loki.yml:ro
      - loki-data:/loki
    mem_limit: 256m

  promtail:
    image: grafana/promtail:3.4.2
    container_name: promtail
    restart: unless-stopped
    command: -config.file=/etc/promtail/promtail.yml
    volumes:
      - ./promtail/promtail.yml:/etc/promtail/promtail.yml:ro
      - /var/lib/docker/containers:/var/lib/docker/containers:ro
      - promtail-data:/data
    depends_on:
      - loki
    mem_limit: 128m

  grafana:
    image: grafana/grafana:12.3.0
    container_name: grafana
    restart: unless-stopped
    env_file: .env                           # admin user and password
    environment:
      GF_USERS_ALLOW_SIGN_UP: "false"
      GF_ANALYTICS_REPORTING_ENABLED: "false"
    volumes:
      - ./grafana/provisioning:/etc/grafana/provisioning:ro
      - grafana-data:/var/lib/grafana
    ports:
      - "127.0.0.1:3500:3000"                # only the proxy reaches Grafana
    mem_limit: 256m

volumes:
  prometheus-data:
  loki-data:
  promtail-data:
  grafana-data:

I use named volumes for data: Prometheus, Loki and Grafana do not run as root inside the container, and with host folders it is easy to end up with permission errors.

On a Synology NAS, containers are not in /var/lib/docker. On mine, cAdvisor and Promtail had to read from /volume1/@docker and /volume1/@docker/containers. Check the path on your system.

The .env (no values in the example; fill them in and run chmod 600 .env):

GF_SECURITY_ADMIN_USER=
GF_SECURITY_ADMIN_PASSWORD=

Step 2: the configuration

prometheus/prometheus.yml, what to measure and how often:

global:
  scrape_interval: 30s        # how often it asks the exporters
  evaluation_interval: 30s    # how often it evaluates alerts

rule_files:
  - /etc/prometheus/alerts.yml

scrape_configs:
  - job_name: prometheus
    static_configs:
      - targets: ["localhost:9090"]

  - job_name: node
    static_configs:
      - targets: ["host.docker.internal:9100"]

  - job_name: cadvisor
    static_configs:
      - targets: ["cadvisor:8080"]

loki/loki.yml, a single-node Loki with 7-day retention:

auth_enabled: false

server:
  http_listen_port: 3100

common:
  path_prefix: /loki
  storage:
    filesystem:
      chunks_directory: /loki/chunks
      rules_directory: /loki/rules
  replication_factor: 1
  ring:
    kvstore:
      store: inmemory

schema_config:
  configs:
    - from: 2024-01-01
      store: tsdb
      object_store: filesystem
      schema: v13
      index:
        prefix: index_
        period: 24h

compactor:
  working_directory: /loki/compactor
  retention_enabled: true          # without this, logs are never deleted
  delete_request_store: filesystem

limits_config:
  retention_period: 168h           # 7 days

promtail/promtail.yml, which reads the logs of every container:

server:
  http_listen_port: 9080
  grpc_listen_port: 0

positions:
  filename: /data/positions.yaml   # remembers where it was after a restart

clients:
  - url: http://loki:3100/loki/api/v1/push

scrape_configs:
  - job_name: docker
    static_configs:
      - targets: [localhost]
        labels:
          job: docker
          __path__: /var/lib/docker/containers/*/*-json.log
    pipeline_stages:
      - docker: {}                 # extracts message and time from Docker's JSON format

Grafana provisions its data sources from a file, so you do not have to configure them by hand. grafana/provisioning/datasources/datasources.yml:

apiVersion: 1

datasources:
  - name: Prometheus
    type: prometheus
    access: proxy
    url: http://prometheus:9090
    isDefault: true

  - name: Loki
    type: loki
    access: proxy
    url: http://loki:3100

A note about Promtail: it is what I use, but Grafana has deprecated it in favour of Grafana Alloy. For a new long-term setup, consider Alloy as the log agent.

Step 3: your first dashboard

docker compose up -d
docker compose ps

Open Grafana through the proxy with the user from .env. Then:

  1. In Dashboards, choose to import a dashboard.
  2. Type the ID 1860 (“Node Exporter Full”, published on grafana.com) and select the Prometheus data source.
  3. You now have the host’s CPU, memory, disk and network.

For logs, open Explore, choose Loki and try a query such as {job="docker"} |= "error".

Step 4: your first alert

prometheus/alerts.yml, two rules that work for any server:

groups:
  - name: homelab
    rules:
      - alert: HostCaido
        expr: up{job="node"} == 0
        for: 2m                              # avoids alerts for a one-off glitch
        labels:
          severity: critical
        annotations:
          summary: "node-exporter has not responded for 2 minutes"

      - alert: DiscoCasiLleno
        expr: |
          node_filesystem_avail_bytes{fstype!~"tmpfs|overlay"}
            / node_filesystem_size_bytes{fstype!~"tmpfs|overlay"} < 0.10
        for: 15m
        labels:
          severity: warning
        annotations:
          summary: "Less than 10% of disk left on {{ $labels.mountpoint }}"

Reload Prometheus with docker compose restart prometheus and open its alerts page: you will see the rules in the inactive state.

An alert that is only visible on a page warns nobody. It happened to me: on the NAS, the alert receiver was empty and every alert was silently discarded. Since the stack moved to the laptop, alerts are sent through ntfy and I have my own rules for the NAS going down, the disk or backups. To send them you need Alertmanager (it comes with kube-prometheus-stack) or Grafana contact points. In the next chapter I set up a Telegram alert channel.

The real case: three days without observability

The migration had a stumble that teaches more than the technical part. When I moved the control plane, I stopped the NAS stack intending to start only the collectors. I did not. For three days there were no metrics or logs, and my documentation still said the NAS stack “was still running” as a fallback.

Two more errors showed up when I started the collectors:

  • Port conflict. For the laptop’s Prometheus to reach cAdvisor, its port had to be published. Port 8080 was already used by Caddy on the NAS. Publishing it there would have broken web access. I published it on another port (8085:8080).
  • depends_on bringing back what was migrated. Promtail depends on Loki in the compose file. A docker compose up -d promtail also started the local Loki, which was exactly the one I had migrated. The fix is --no-deps:
docker compose up -d --no-deps node-exporter cadvisor promtail

The lesson: documentation that is not checked against reality is worse than no documentation, because it gives you a false sense of safety.

Common problems

Symptom Likely cause Fix
The node target shows as DOWN Prometheus cannot reach the host Check extra_hosts and the firewall for port 9100
permission denied on /prometheus or /loki Host folder with a different owner Use named volumes
Promtail sends nothing Different log path (e.g. on Synology) Mount the real container path
Loki keeps growing Retention not enabled retention_enabled and retention_period
The NAS is slow with the stack running Not enough RAM, swap in use Memory limits or move the control plane
A Loki you did not want starts up depends_on in Promtail docker compose up -d --no-deps ...

Conclusion

Having metrics and logs in one place changed the way I troubleshoot: I no longer guess, I look. The lessons I take away: limit memory and retention from the start, separate what must live on the host from what can move to another machine, and verify that what your documentation says is true.

In the next chapter I set up Diun to know when new images are out and a Telegram bot so alerts reach my phone.

Preguntas frecuentes

¿Necesito Kubernetes para tener observabilidad en casa?

No. Con Docker Compose en una sola máquina funciona perfectamente. Yo moví el plano de control a k3s por falta de RAM en el NAS y para aprender Kubernetes con un caso real.

¿Cuánta memoria necesita este stack?

En mi caso, el stack completo usaba unos 670 MB reales. El problema no era su peso, sino el margen que dejaba al NAS: fíjale límites y vigila el uso de swap.

¿Por qué no instalé k3s directamente en el NAS?

Porque el sistema de mi NAS usa un kernel antiguo, un esquema de cgroups no estándar y no carga overlayfs. k3s habría fallado o quedado muy frágil.

Fuentes
Proyecto relacionado

Infraestructura Pesoz

Homelab self-hosted en producción 24/7: un NAS Synology con ~30 servicios en Docker tras Caddy + CrowdSec y un portátil con GPU como servidor de IA y observabilidad en k3s. VPN WireGuard, GitOps con Forgejo y estado en vivo con Uptime Kuma.
Compartir:LinkedInX
ivanjonasfc@dev: ~ — zshsesión en vivo

❯ neofetch

Perfilivanjonasfc@dev

Iván Jonás Fernández Correa
user
ivanjonasfc@dev
role
Full-Stack & DevOps
loc
Gijón, Asturias
títulos
DAM + ASIR
stack
Java · Python · TS · Docker · Linux · IA
busco
Full-Stack · DevOps · Sistemas
status
Disponible para trabajar

❯ uptime --human

Años en tecnología
6+
Proyectos en producción
6
Proyectos entregados
10+
Servicios self-hosted
~30

❯ figlet "Iván Jonás"

# Hola, soyIván Jonás

Desarrollador Full-Stack & DevOpsFull-Stack Developer & DevOps

Desarrollador Full-Stack & DevOps · Gijón, Asturias · ● Disponible para trabajar

↓ desliza, toca o escribe para abrir la sesión

❯ cat about.md

Desarrollo aplicaciones web y móviles de principio a fin (Java/Spring Boot, Python/FastAPI, TypeScript/React y Flutter) y me ocupo de su puesta en producción y operación con Docker, Linux, CI/CD y monitorización. Actualmente administro la infraestructura IT de una pyme y mantengo un homelab de unos 30 servicios en el que evalúo nuevas tecnologías, incluida IA local y privada (Ollama, RAG, MCP). Técnico Superior en DAM y ASIR.

❯ ls ~

Iván en números

Mi actividad en GitHub, mi trayectoria y mi infraestructura · datos en vivo.

Community

0

followers

followerfollowerfollowerfollowerfollower+8

Lenguajes

TypeScript32%
Dart14%
Python12%
HTML7%
SCSS5%

Tech Stack

Frontend

React
Next.js
Angular
Astro
Ionic
Flutter
TypeScript
Tailwind
shadcn/ui
React
Next.js
Angular
Astro
Ionic
Flutter
TypeScript
Tailwind
shadcn/ui

Backend

NestJS
FastAPI
Spring Boot
Python
Java
PostgreSQL
Redis
Qdrant
pgvector
MCP
RAG
LLMs
NestJS
FastAPI
Spring Boot
Python
Java
PostgreSQL
Redis
Qdrant
pgvector
MCP
RAG
LLMs

Tools

Docker
Linux
Nginx
Cloudflare
Forgejo
n8n
WireGuard
Prometheus
Grafana
Git
Windows Server
Active Directory
Loki
Tempo
Docker
Linux
Nginx
Cloudflare
Forgejo
n8n
WireGuard
Prometheus
Grafana
Git
Windows Server
Active Directory
Loki
Tempo

Proyectos Destacados

Soluciones reales a problemas reales. Una selección de mis trabajos más recientes.

Web Rutas Raíces
Cliente real

Web Rutas Raíces

Web de senderismo para cliente real en Asturias. Astro 7 + React 19 + Tailwind 4, mapas Leaflet con perfil de elevación a partir de GPX y versión bilingüe ES/EN. Alta de rutas automatizada con n8n + IA; WebP, CSP y cumplimiento RGPD.

AstroReactLeafletn8n
Infraestructura IT para una pyme
Cliente real

Infraestructura IT para una pyme

Diseño, implantación y soporte continuo de la infraestructura IT de una pequeña empresa que trabajaba desde un único portátil: NAS en RAID 1 con Btrfs y snapshots, permisos por grupos sobre SMB, puestos Windows 11 y una capa Docker para gestión documental, automatización y monitorización.

NASRAID 1BtrfsWindows 11DockerPaperless-ngx
OposApp
TFG

OposApp

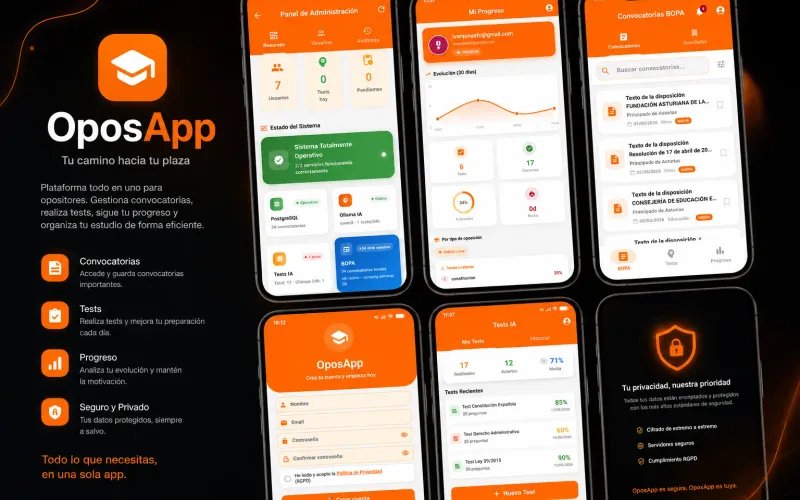
Mi Trabajo de Fin de Grado (DAM): app móvil en Flutter que automatiza el seguimiento de convocatorias del BOPA y genera tests de práctica con IA local (Ollama), con privacidad total por diseño.

FlutterSpring BootIA Local (Ollama)PostgreSQLRGPD
English Brain — Tu coach de entrevistas en inglés con IA, autoalojado
Open Source · Activo

English Brain — Tu coach de entrevistas en inglés con IA, autoalojado

Una plataforma privada y autoalojada para preparar entrevistas técnicas en inglés hablando, no escribiendo. Tocas un orbe, hablas, y el coach te transcribe, te corrige la pronunciación fonema a fonema y te programa el repaso con repetición espaciada (py-fsrs). Toda la IA —el modelo de lenguaje, el reconocimiento de voz y la síntesis— corre en tu propio hardware: tu voz y tus respuestas nunca salen de tu red. Por dentro: cliente Flutter (Android, Web y Windows), orquestador FastAPI y una arquitectura GPU híbrida sobre Docker + Caddy.

IA localVozFlutterFastAPISelf-hostedPronunciación
QuantumSec — Kompliance
FCT 2025

QuantumSec — Kompliance

Prácticas FCT en remoto en una empresa de ciberseguridad (plataforma de cumplimiento Kompliance). Llevé su gestor de auditorías de Supabase a una API propia self-hosted con FastAPI: multitenancy validado por JWT, secretos cifrados, logs de auditoría inmutables y un gestor de contraseñas con claves de un solo uso cifradas.

FastAPIReactTypeScriptPostgreSQLSeguridad
DozeForge — Control total de tu Android por ADB (sin root)
Open Source · Beta 1

DozeForge — Control total de tu Android por ADB (sin root)

App de escritorio que te da el control real de tu Android desde el PC, sin rootear. La conectas por ADB y optimizas batería, memoria, red y decenas de ajustes del sistema desde un solo sitio: caza las apps que te drenan la batería (aunque se escondan tras Google Play Services), quita bloatware de fábrica y aplica perfiles de un clic — y todo es reversible con rollback atómico. Por dentro: Tauri 2 + Rust + SvelteKit 5, telemetría real (dumpsys/sysfs) y primitivas públicas de Android.

Android sin rootOptimizaciónTauri 2RustSvelteKit
SubsForge — Subtítulos con IA, 100% en local
Open Source

SubsForge — Subtítulos con IA, 100% en local

App de escritorio para traducir, generar, sincronizar, fusionar, limpiar, doblar, resumir e incrustar subtítulos de vídeo con IA — sin servicios de terceros y funcionando 100% en tu máquina. Nueve herramientas en una: traducción por lotes (nube u Ollama local), transcripción con Whisper, sincronización por detección de voz (VAD), doblaje con voces TTS, hardsub y limpieza de audio. Por dentro: Tauri 2 + Rust como puente y un sidecar de Python (faster-whisper, FFmpeg, ffsubsync, edge-tts) que hace el trabajo pesado sin bloquear nunca la interfaz.

Subtítulos IAWhisperTauri 2RustPython100% local
OrquestaGit — Tu DevOps senior local con IA
Open Source · En desarrollo

OrquestaGit — Tu DevOps senior local con IA

Una app de escritorio que automatiza el trabajo repetitivo de DevOps sobre tus repositorios: escanea su estado, bloquea secretos antes de cada commit, genera pipelines de CI/CD y audita dependencias, todo desde un único panel de control. La IA corre en local con Ollama, así que tu código nunca sale de tu equipo. Construida con Tauri 2 y un motor de orquestación en Python.

DevOpsIA localSeguridadTauri 2PythonCI/CD
Job-radar · Empleo CRM
Open Source

Job-radar · Empleo CRM

CRM web self-hosted que automatiza y centraliza mi búsqueda de empleo: reúne las ofertas, las puntúa con IA (Groq/Gemini/Ollama), genera carta y ajustes de CV, y las sigue en un kanban. Astro SSR + React + PostgreSQL, todo configurable desde la web y replicable con un comando.

Astro SSRReactPostgreSQLIA · LLMsn8nDocker
LifeOS — Suite familiar con IA
En desarrollo

LifeOS — Suite familiar con IA

Suite SaaS familiar autohospedada con IA propia ("Lito"). Backend NestJS + PostgreSQL + BullMQ y app Angular 18 + Ionic. RAG sobre pgvector/Qdrant y LLMs vía Model Context Protocol (MCP). Módulos de chat, gastos con splits en tiempo real, calendario, nube y notas.

NestJSAngularIA / RAGMCPDocker
Infraestructura Pesoz
En Producción

Infraestructura Pesoz

Homelab self-hosted en producción 24/7: un NAS Synology con ~30 servicios en Docker tras Caddy + CrowdSec y un portátil con GPU como servidor de IA y observabilidad en k3s. VPN WireGuard, GitOps con Forgejo y estado en vivo con Uptime Kuma.
Dockerk3sCaddyWireGuardCI/CDObservabilidad
Hooklab
Nuevo

Hooklab

Constructor, firmador y verificador de webhooks 100% en el navegador: crea payloads con variables simuladas, firma y verifica HMAC (GitHub, Stripe, Shopify, Slack), genera con IA local y dispara un POST. Zero-backend, con el estado compartible en la URL.

AstroZero-backendWeb CryptoIA local
Acopio de Código
Nuevo

Acopio de Código

Página web interactiva con snippets de código de varios lenguajes: busca, copia y ten todo a mano. Autohospedada en mi propia infraestructura.

ReactSnippetsSelf-hosted
Vagabond Battery Saver
Open Source

Vagabond Battery Saver

Módulo Magisk para Android root. Optimización agresiva de batería mediante gestión de governors de CPU y perfiles de energía al bloquear la pantalla.

AndroidShell ScriptMagisk
Happines&CO
Educativo

Happines&CO

Sitio web corporativo para empresa de eventos, desarrollado durante el ciclo de DAM. Diseño responsive y estructura semántica limpia.

HTML5CSS3JavaScript
Portfolio Web
Meta

Portfolio Web

Este mismo sitio. Astro 7 + React (islas) + Tailwind, self-hosted con Docker y Caddy. Cada proyecto es una carpeta con su contenido y se da de alta con un script (npm run proyecto:add).

AstroReactTailwindSelf-hosted

Últimas publicaciones

Guías prácticas probadas en mi propia infraestructura.

Portada: escudo con símbolo de prohibido sobre fondo oscuro con el título AdGuard Home
Redes y seguridad

AdGuard Home en Docker: sin publicidad en toda la casa y tus subdominios en local

Monto AdGuard Home en Docker para bloquear publicidad en toda la red, usar DNS cifrado y resolver mis subdominios en casa sin depender del router.

8 min de lectura

#adguard-home#dns#docker#privacidad#homelab
Leer
Portada: candado con flechas de entrada sobre fondo oscuro con el título Caddy como puerta de entrada
Redes y seguridad

Caddy como puerta de entrada del homelab: HTTPS, cabeceras seguras y CrowdSec

Cómo uso Caddy en Docker como única entrada a mi NAS: HTTPS por DNS de Cloudflare, snippets de seguridad, paneles solo LAN y CrowdSec contra IPs abusivas.

11 min de lectura

#caddy#https#docker#crowdsec#seguridad#cloudflare
Leer
Portada: una caja de contenedor con una campana de aviso y un avión de papel sobre fondo oscuro con el título Diun y Telegram
Automatización

Diun y alertas en Telegram: entérate de las imágenes nuevas sin actualizar a ciegas

Uso Diun para saber cuándo hay imágenes Docker nuevas y un único bot de Telegram para recibir los avisos de Diun, CrowdSec y Uptime Kuma.
7 min de lectura

#diun#docker#telegram#alertas#observabilidad
Leer
Portada: ramas de Git que se unen en una marca de verificación sobre fondo oscuro con el título Forgejo y GitHub Actions
Automatización

Forgejo y GitHub Actions: tu infraestructura en Git y un repo público profesional

Monto Forgejo en casa como fuente de verdad de mi infraestructura, protejo los secretos y preparo un repo público con CI, Dependabot y plantillas.

13 min de lectura

#git#forgejo#github-actions#ci#gitops#buenas-practicas
Leer
Portada: logotipo de reproducción sobre fondo oscuro con el título Jellyfin en mi NAS
Homelab

Jellyfin en un NAS: Docker, transcoding por hardware y la TV que no quería conectar

Cómo monto Jellyfin en un NAS con Intel, activo el transcoding por GPU, lo publico con Caddy y arreglo el error -27 de las TV LG antiguas.

7 min de lectura

#jellyfin#docker#nas#caddy#transcoding#synology
Leer
Portada: gráfica de líneas y barras de un panel de métricas sobre fondo oscuro con el título Observabilidad en casa
Homelab

Observabilidad en casa: Grafana, Prometheus y Loki sin ahogar el NAS

Monto métricas, logs y alertas con Prometheus, Grafana y Loki, y cuento por qué acabé moviendo el stack del NAS a un portátil con k3s.

11 min de lectura

#grafana#prometheus#loki#observabilidad#docker#kubernetes
Leer
Portada: línea de latido y barras de disponibilidad sobre fondo oscuro con el título Uptime Kuma
Homelab

Uptime Kuma: vigila tus servicios y enseña su estado en vivo en tu CV

Monto Uptime Kuma en Docker, configuro monitores y avisos útiles, publico solo la página de estado y la muestro en mi portfolio con un widget en JS.

8 min de lectura

#uptime-kuma#monitorizacion#docker#caddy#portfolio
Leer

Trabajemos juntos

¿Buscas un perfil full-stack / DevOps, un colaborador o un freelance? Cuéntame qué necesitas y te respondo en menos de 24 h.

ivanjonasfc@dev:~/contacto

# ¿Qué te trae por aquí?

↳
↳
↳

Sin spam. Tus datos solo se usan para responderte.

Terminal interactiva